検証記録
外部リンクほぼゼロで始めたサイトの最初の1ヶ月:クローラとインデックスの記録
要約
- 東京都の丁目ごとのデータページを、外部からのリンクがほとんどない状態で公開し、31日間のクローラのアクセスを記録しました。記録したのは2,938件、クローラは約40種類です。
- AI 系のクローラは速く、Google と Bing は遅い。ClaudeBot は追加した361ページを公開から1.6時間で全件取得しました。一方、Googlebot が1回でも取得したのは785ページ中189ページ(24%)で、そのうち50件は手動でリクエストした分です。
- Google にとっての問題は「見つけられない」ことではなく、「取りに来る理由がない」ことでした。Search Console は全 URL を認識していながら、50件を一度もクロールしていませんでした。
- Bing は、IndexNow で通知した50件しか取りに来ませんでした。通知していない735件は、sitemap を22回読んでいても0件です。
1. 背景
herahin.net は、東京都の丁目ごとに「herahinスコア」という指標を載せたサイトです。もともとは、LLM や Google の AI Overview がどんなページを引用するかを調べるために作りました。ページの書き方の違いが引用に影響するかを比べるので、比べる条件以外はなるべく揃えています。
この検証では、検索エンジンや AI に「自然に」見つけてもらう過程も観察の対象です。そこで、宣伝や外部からのリンクをほとんど作らずに公開しました。この記事は、その最初の1ヶ月にどのクローラが、いつ、何を取りに来たかの記録です。
ページの書き方の違いや、どのページがどの条件に割り当てられているかは、検証の途中なのでここでは書きません。
2. 条件の開示
追試できるように、何をしたかをできるだけ書いておきます。
2.1 サイトと公開の日程
ドメイン自体は以前から持っていて、空のサイトを置いていました(旧 WordPress の痕跡が Search Console の参照元に残っていました)。今の形式のサイトにしたのが 2026年9月13日 で、アクセスの記録もこの日から始めています。
| 日付 | 公開したもの | 丁目ページの累計 |
|---|---|---|
| 9/14 | 練馬区の50丁目 | 50 |
| 10/3 23:15 | 練馬区の残り150・中野区85・杉並区139 | 424 |
| 10/9 10:20 | 板橋区131・豊島区83・新宿区147 | 785 |
ページは Hugo で生成し、Vercel で配信しています。丁目ページは、区のページと隣接する丁目へのリンクでつながっています。
2.2 「外部リンクほぼゼロ」の中身
この1ヶ月のあいだに herahin.net へリンクしたのは、次のサイトです。
| 日付 | リンク元 | リンク先 |
|---|---|---|
| 10/4 | 自分のサイト asahi44.net(同じ日に公開)。プロジェクト一覧、全ページのフッター、事前登録の記事 | トップ・about |
外部リンク(ほかのドメインのサイトに herahin.net の URL を掲載すること)は、これ一つのみで SNS や他のサイトへの投稿等はしていません。
外部リンクとは別に、検索エンジンへの通知や手動の操作を次のとおり行っています。リンクではありませんが、クロールのきっかけにはなり得るので、あわせて開示します。
| 日付 | 行ったこと | 対象 |
|---|---|---|
| 9/13〜 | Search Console に sitemap を登録 | サイト全体 |
| 9/17 | robots.txt に Sitemap 行を追加 | サイト全体 |
| 9/17 | IndexNow で55 URL を通知(1回のみ) | 最初の50丁目とハブページ |
| 9/24 | Search Console で手動のインデックス登録リクエスト | トップ(www と apex) |
| 9/25 | 手動のインデックス登録リクエスト | 最初の50丁目のうち3件 |
| 10/3〜10/7 | 手動のインデックス登録リクエスト | 最初の50丁目の残り(1日9件ずつ。10/7 までに50件すべてが登録) |
10/3 以降に公開した735ページには、手動リクエストも IndexNow も使っていません。
2.3 計測方法
- アクセスの記録:Vercel のミドルウェアで、ページ、robots.txt、sitemap.xml へのリクエストをすべて Supabase に記録しました。ユーザーエージェント(UA)、パス、IP、時刻を保存しています。CSS やフォントなどの静的ファイルは、9/18 から記録の対象外です。
- 記録に残らないもの:Vercel の DDoS 対策で拒否されたリクエストは、ミドルウェアまで届かないので記録されません(
/.envを狙うような攻撃的なアクセスが該当)。 - クローラの判定:UA の文字列で判定しています。UA を偽装したアクセスは区別できません。
- インデックスの状態:Google Search Console の URL 検査 API とカバレッジのレポートを使いました。
- 人の閲覧:Google Analytics 4 で確認しました。
- 時刻はすべて日本時間です(ログは UTC、Search Console の表示は JST なので9時間ずらして突き合わせています)。
- Search Console のライブテストの注意:URL 検査のライブテストは、リダイレクトを自動でたどって最終的な URL の結果を表示します。9/24 に www へのリダイレクトが効いていないように見えたのはこのためで、実際には正常でした。リダイレクトの確認には curl などを使っています。
3. 結果
3.1 どのクローラが来たか
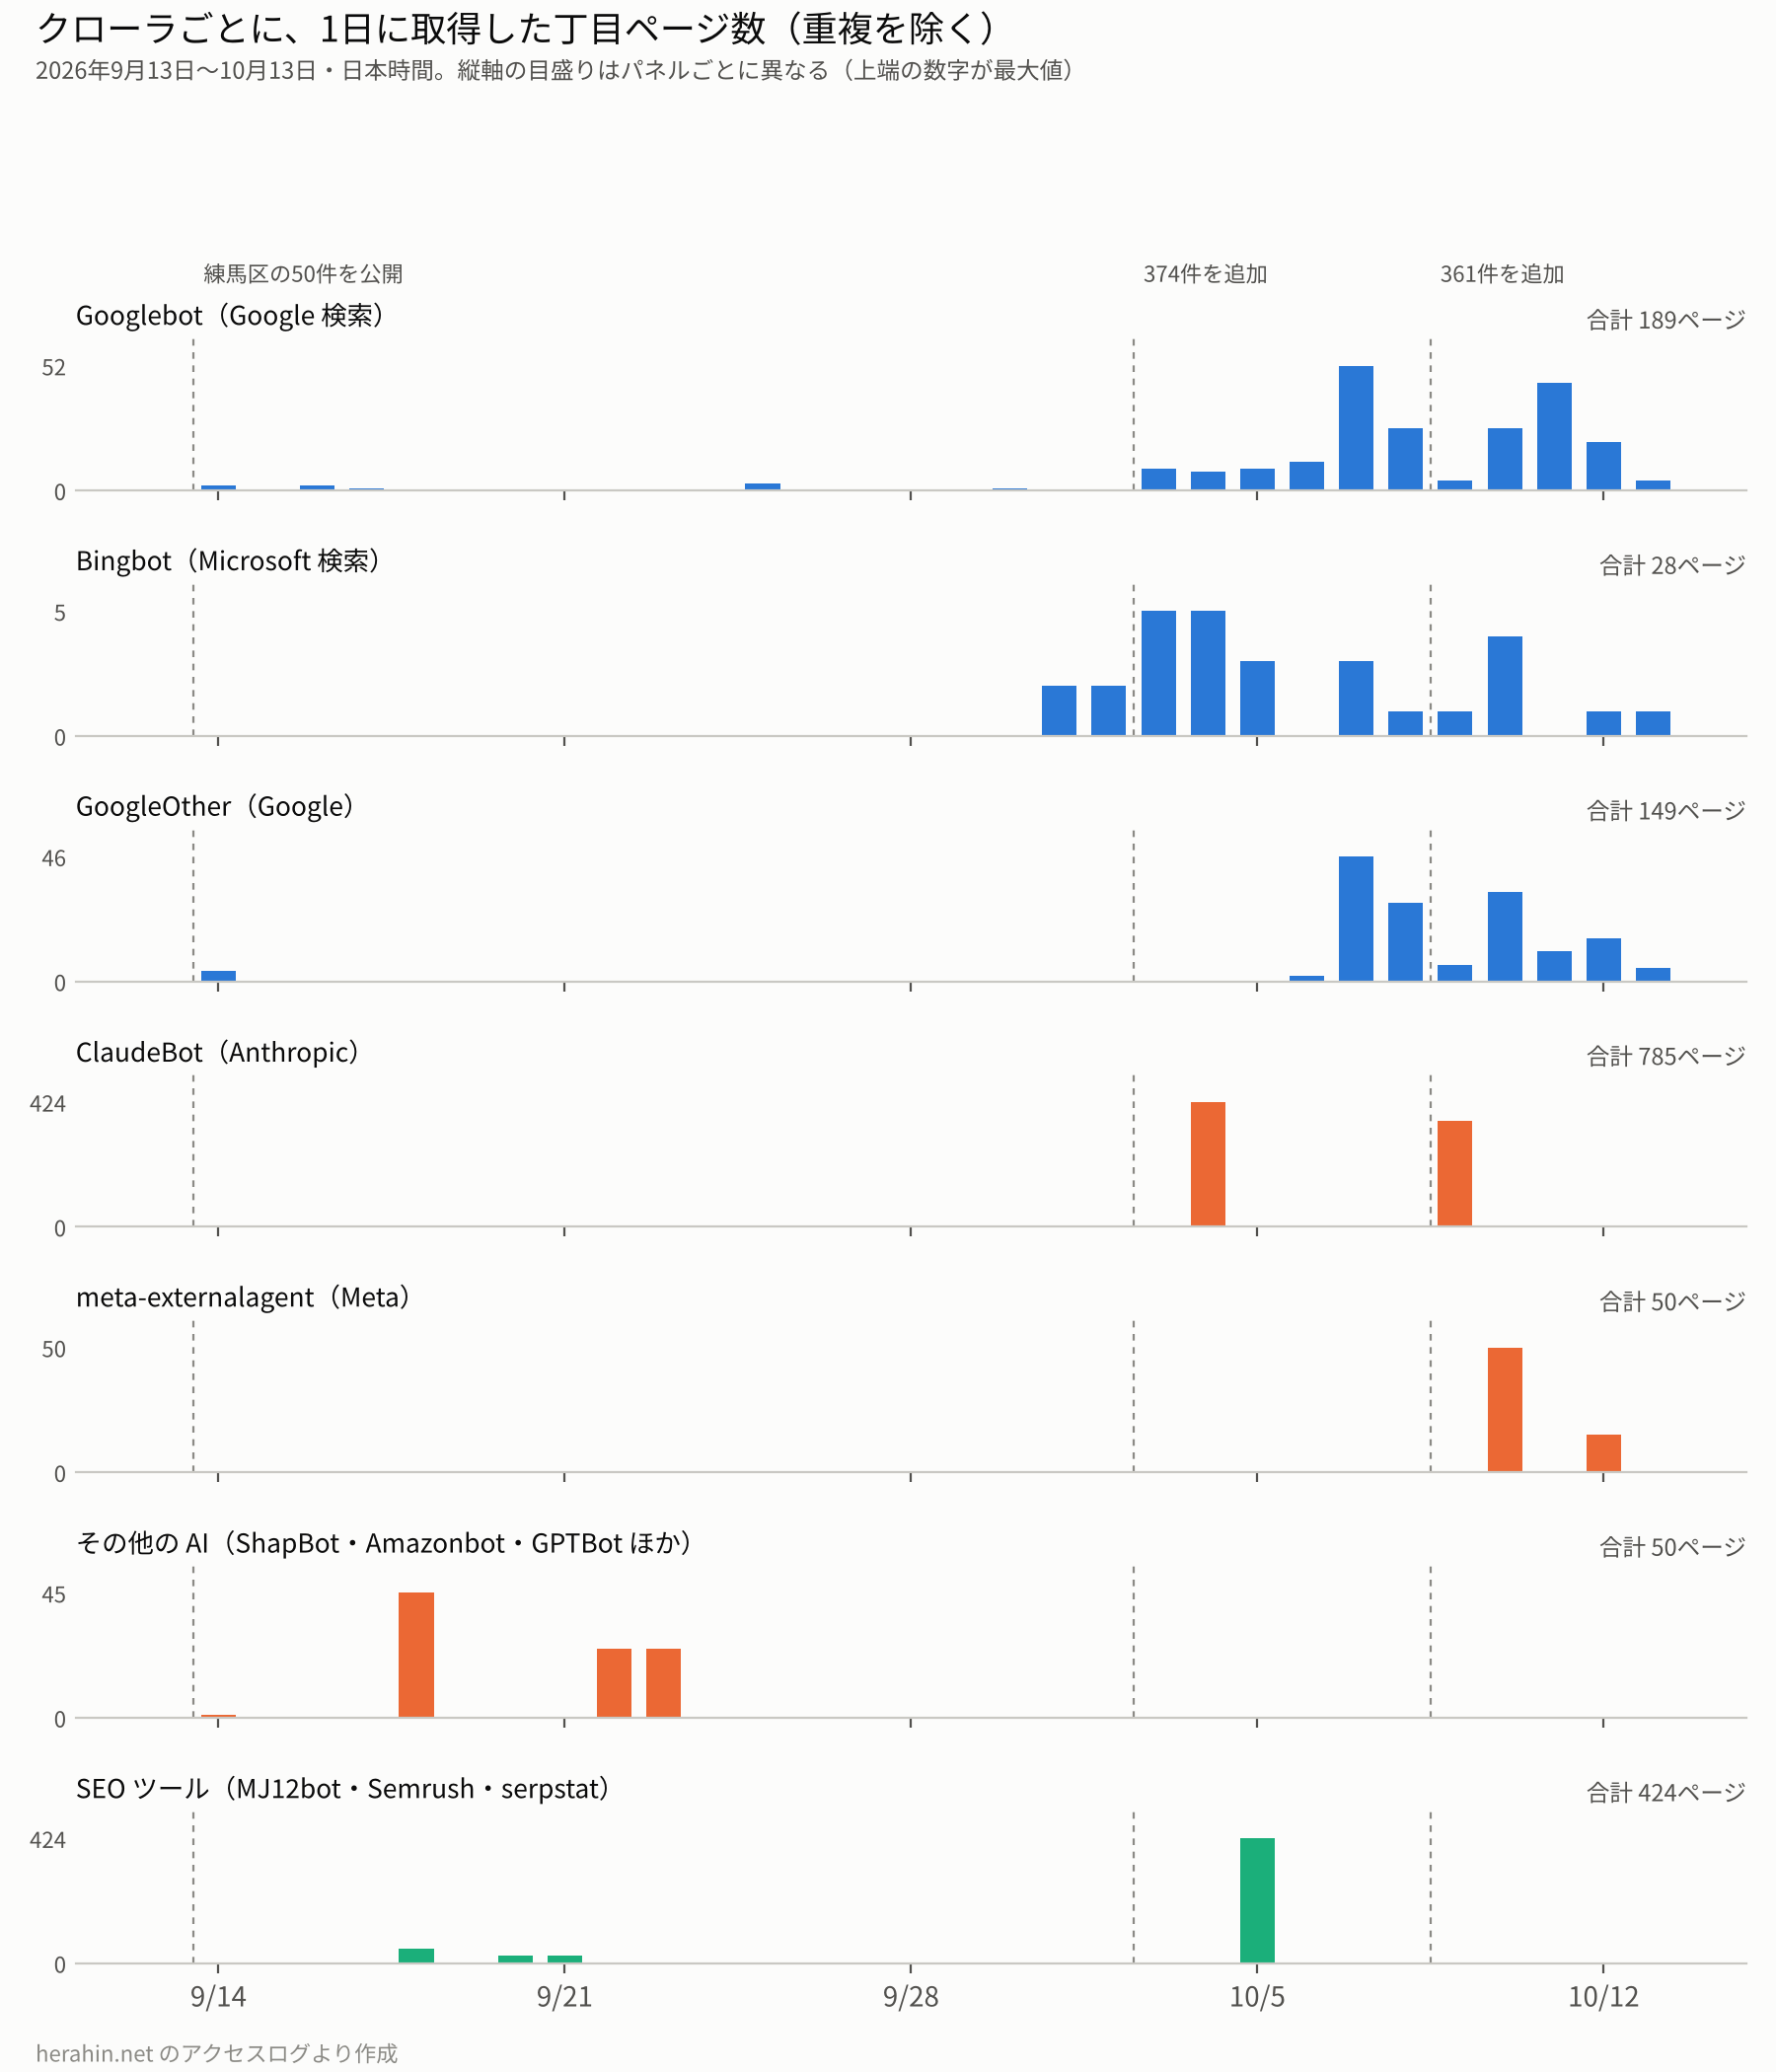 図1:クローラごとに、1日に取得した丁目ページ数(9/13〜10/13)
| クローラ | 運営元 | 目的 | 初めて来た日 | リクエスト | 丁目ページ | 取得割合 |
|---|---|---|---|---|---|---|
| Googlebot | 検索 | 9/13 | 489 | 189 | 24% | |
| Bingbot | Microsoft | 検索 | 9/13 | 155 | 28 | 4% |
| GoogleOther | 研究開発など | 9/13 | 173 | 149 | 19% | |
| OAI-SearchBot | OpenAI | ChatGPT の検索 | 9/14 | 53 | 0 | 0% |
| ShapBot | Parallel Web Systems | AI 向けの検索インデックス | 9/17 | 85 | 45 | 6% |
| ClaudeBot | Anthropic | AI の学習 | 10/4 | 1,016 | 785(全件) | 100% |
| GPTBot | OpenAI | AI の学習 | 9/14 | 31 | 1 | 0.1% |
| meta-externalagent | Meta | AI の学習・製品改善 | 10/3 | 74 | 50 | 6% |
| Amazonbot | Amazon | 自社サービスの改善 | 9/19 | 60 | 50 | 6% |
| MJ12bot | Majestic | SEO(被リンク調査) | 10/5 | 439 | 424(その時点の全件) | 54% |
| SemrushBot / AhrefsBot / serpstatbot | 各 SEO ツール | SEO 分析 | 9/14〜 | 77 / 72 / 56 | 50 / 0 / 50 | 6% / 0% / 6% |
取得割合は、10/13 時点で公開していた785件に対する割合です。10/3 より前に公開していたのは最初の50件だけです。なので、9月に「50件」を取ったクローラ(Amazonbot、SemrushBot、serpstatbot)は、その時点の全件を取ったことになります。
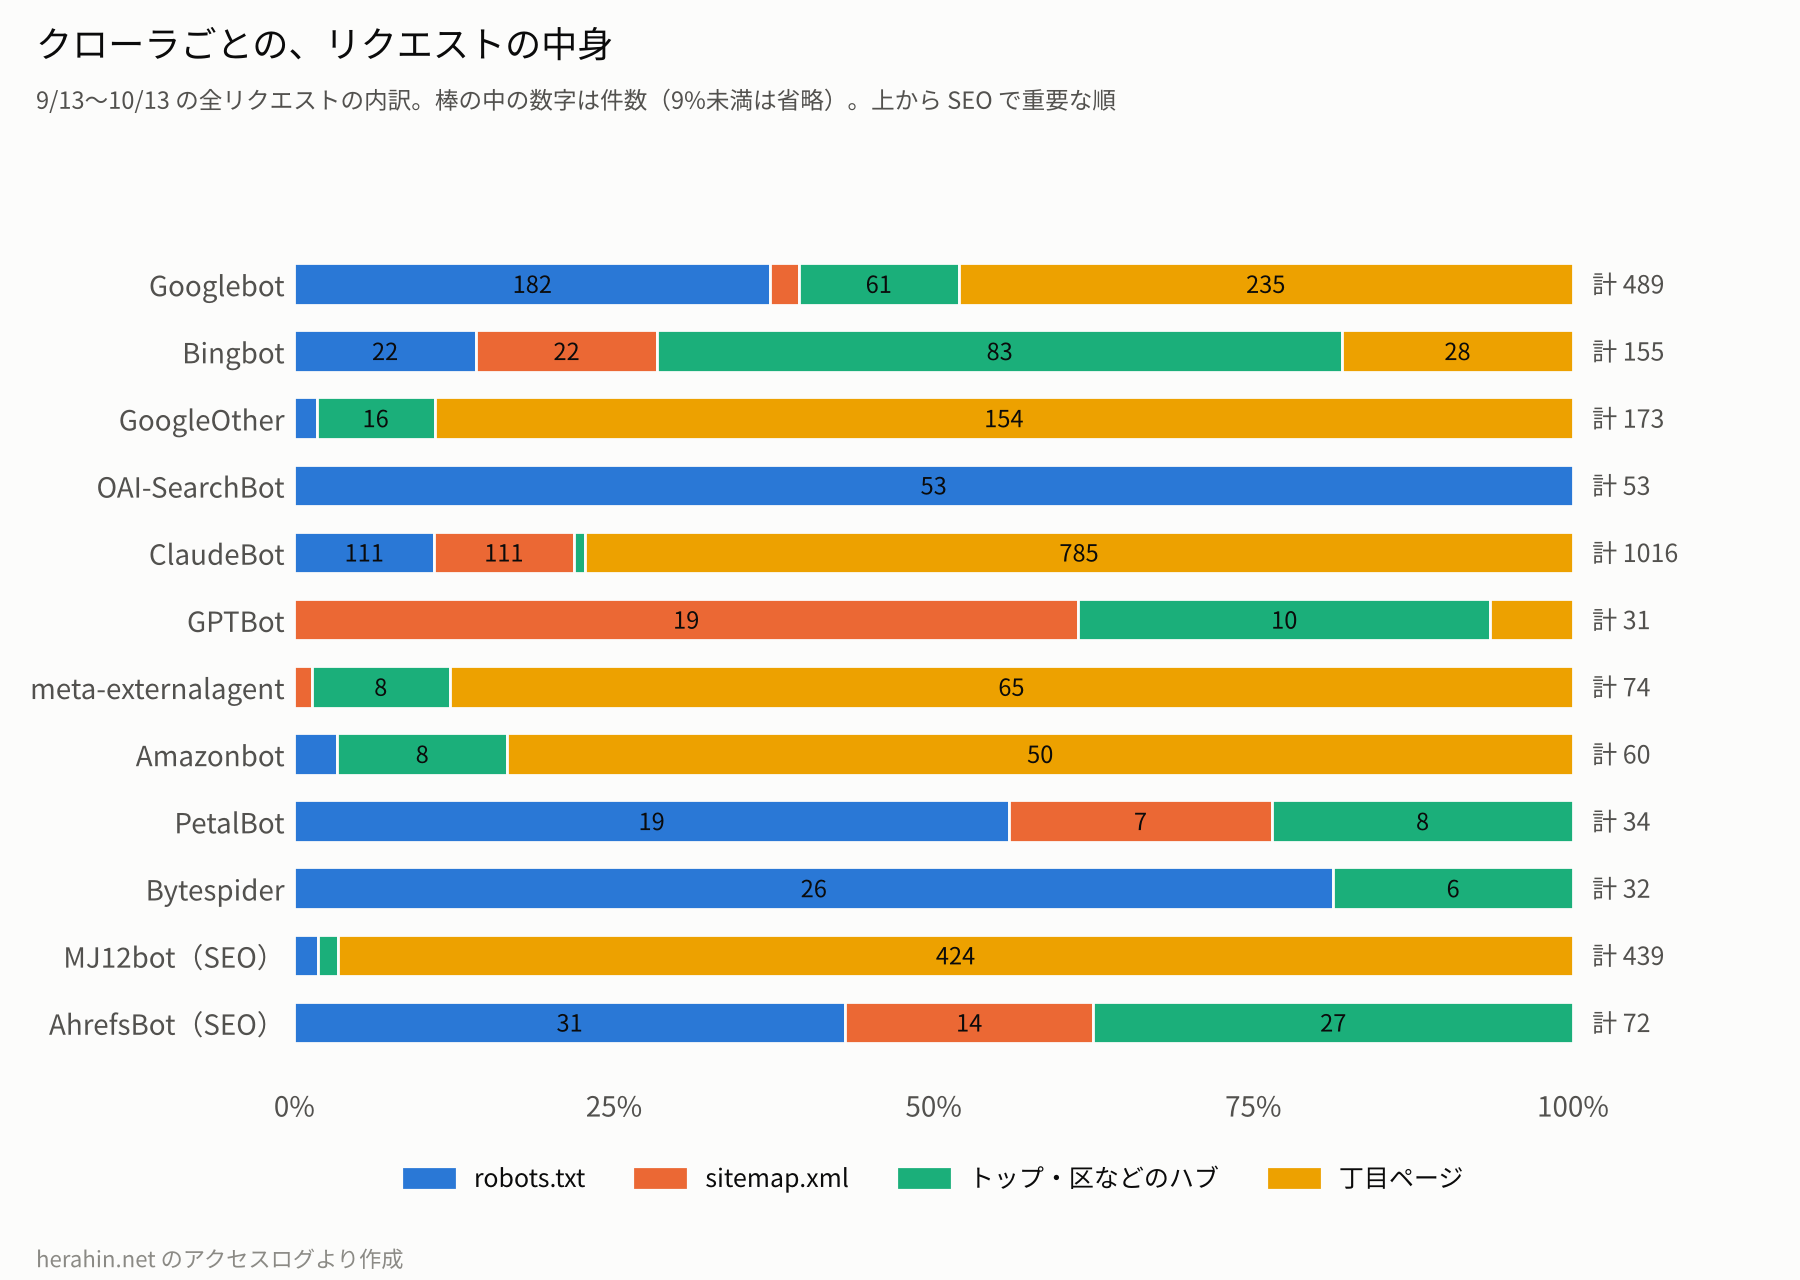 図2:クローラごとのリクエストの内訳(9/13〜10/13)
公開してから、各クローラが丁目ページを取りに来るまでの時間です。セルは「最初の1件まで/取得したページの中央値(10/13 までに取得した数/公開した数)」です。
| クローラ | 9/14 公開(50件・手動リクエストあり) | 10/3 公開(374件) | 10/9 公開(361件) |
|---|---|---|---|
| Googlebot | 9.6時間/20.8日(50/50) | 2.3日/4.1日(90/374) | 30.6時間/45.9時間(49/361) |
| Bingbot | 17.5日/20.8日(28/50) | —(0件) | —(0件) |
| GoogleOther | 9.4時間/27.5日(27/50) | 2.3日/4.1日(100/374) | 29.7時間/31.1時間(22/361) |
| ShapBot | 3.9日/3.9日(45/50) | —(0件) | —(0件) |
| ClaudeBot | 20.5日/20.5日(50/50) | 22.0時間/22.1時間(374/374) | 1.6時間/1.6時間(361/361) |
| meta-externalagent | 26.2日/26.3日(50/50) | —(0件) | —(0件) |
| Amazonbot | 8.1日/8.6日(50/50) | —(0件) | —(0件) |
| MJ12bot | 21.2日/21.3日(50/50) | 38.9時間/40.2時間(374/374) | —(0件) |
| SemrushBot | 6.4日/6.6日(50/50) | —(0件) | —(0件) |
| serpstatbot | 4.2日/4.2日(50/50) | —(0件) | —(0件) |
- 9/14 公開分の ClaudeBot(20.5日)と meta-externalagent(26.2日)は、サイトに初めて来たのがその時期だったためです。
- 中央値は、10/13 までに取得されたページだけで計算しています。10/9 公開分は4.6日分しか見ていません。
- 9/14 公開分の Googlebot は、手動リクエストによる取得を含みます。
3.2 巡回の仕方は3つに分かれる
| 型 | 例 | 動き |
|---|---|---|
| sitemap を一気に取る | ClaudeBot、ShapBot、MJ12bot | sitemap の URL をまとめて取る。ClaudeBot は424件を4分、ShapBot は45件を22分 |
| リンクを順にたどる | serpstatbot | robots.txt → トップから、階層ごとに約33分空けて1段ずつ降りる。9/18 に50件を踏破 |
| 区のページで止まり、少しずつ広がる | Googlebot、Bingbot | robots.txt と sitemap も読むが、丁目ページへは数日〜数週間かけて少しずつ |
sitemap を一気に取る型と、リンクを順にたどる型の両方が全件に届いています。サイトの構造(sitemap や内部リンク)に技術的な問題はありませんでした。Google と Bing が遅い理由は、別のところにあります。
3.3 Google:知っているのに取りに来ない
9月:最初の3日だけ動いて、止まる
Googlebot は、公開した 9/14 から 9/17 までに、50件のうち4件を取得しました。その後、10/3 まで丁目ページを1件も取りに来ていません。
9/25 に Search Console を確認すると、sitemap の55 URL のうち50件が「検出 - インデックス未登録」で、前回のクロールはすべて「該当なし」でした。区のページや丁目の一覧ページも未クロールで、階層が途中で途切れていました。Google は全 URL を認識したうえで、取りに来ていなかったのです。この状態は 9/21 から横ばいでした。
ただし、この4件は取られ方が2種類に分かれます。
| 日時 | ページ | 取られ方 |
|---|---|---|
| 9/14 18:34、21:10 | 2件 | sitemap を読んだ約20分後。GoogleOther が5〜7分前に先に取得し、Googlebot はスマホ版のみ |
| 9/16 01:01、11:20(9/17 01:31 に1件を再取得) | 2件と練馬区のページ | PC 版が robots.txt を読んだ直後に、PC 版とスマホ版が数秒差で同じページを取得。GoogleOther は来ていない |
Google アナリティクスを見ると、9/16 に自分がトップから練馬区のページを経て、まさにこの丁目ページを閲覧していました。2ヶ月目に入ってから、PC 版とスマホ版の同時取得は自分がブラウザでページを見たあとに出やすい形だとわかりました(2本目の記事で詳しく書きます)。なので、9月に自然に取得されたと言えるのは 9/14 の2件だけで、9/16 の分は自分の閲覧がきっかけだった可能性が高いと考えています。
取りに来れば、ほぼ登録される
9/25 に、まだ取得されていない丁目から機械的に選んだ3件を手動でリクエストしました(ハッシュ値が最小のものを選ぶ方式)。この時期、Google アナリティクス上の閲覧はトップページだけで、丁目ページは自分も含めて誰も見ていません。3件とも当日中にクロールされ、同日にインデックスに登録されました。スコアの高低や書き方とは関係なく登録されたので、ページの質で弾かれているのではなく、クロールの順番が回ってこないことが問題だと判断しました。
Google は、どれだけクロールするかを「クロールの容量」と「クロールの需要」で決めると説明しています(クロール バジェットの最適化 )。需要に効くものとして挙げられているのは、URL の量、人気(ウェブ上でよく参照されているページほど頻繁にクロールされる)、古さ(変化を拾うための再クロール)です。容量に余裕があっても、需要が低ければクロールは増えないとも書かれています。新しいサイトで、外部からのリンクも検索での表示もないページは、需要が低いと判断されたと考えられます。
sitemap を読む間隔が延びていく
Googlebot が sitemap.xml を読んだ間隔は、次のように延びていきました。
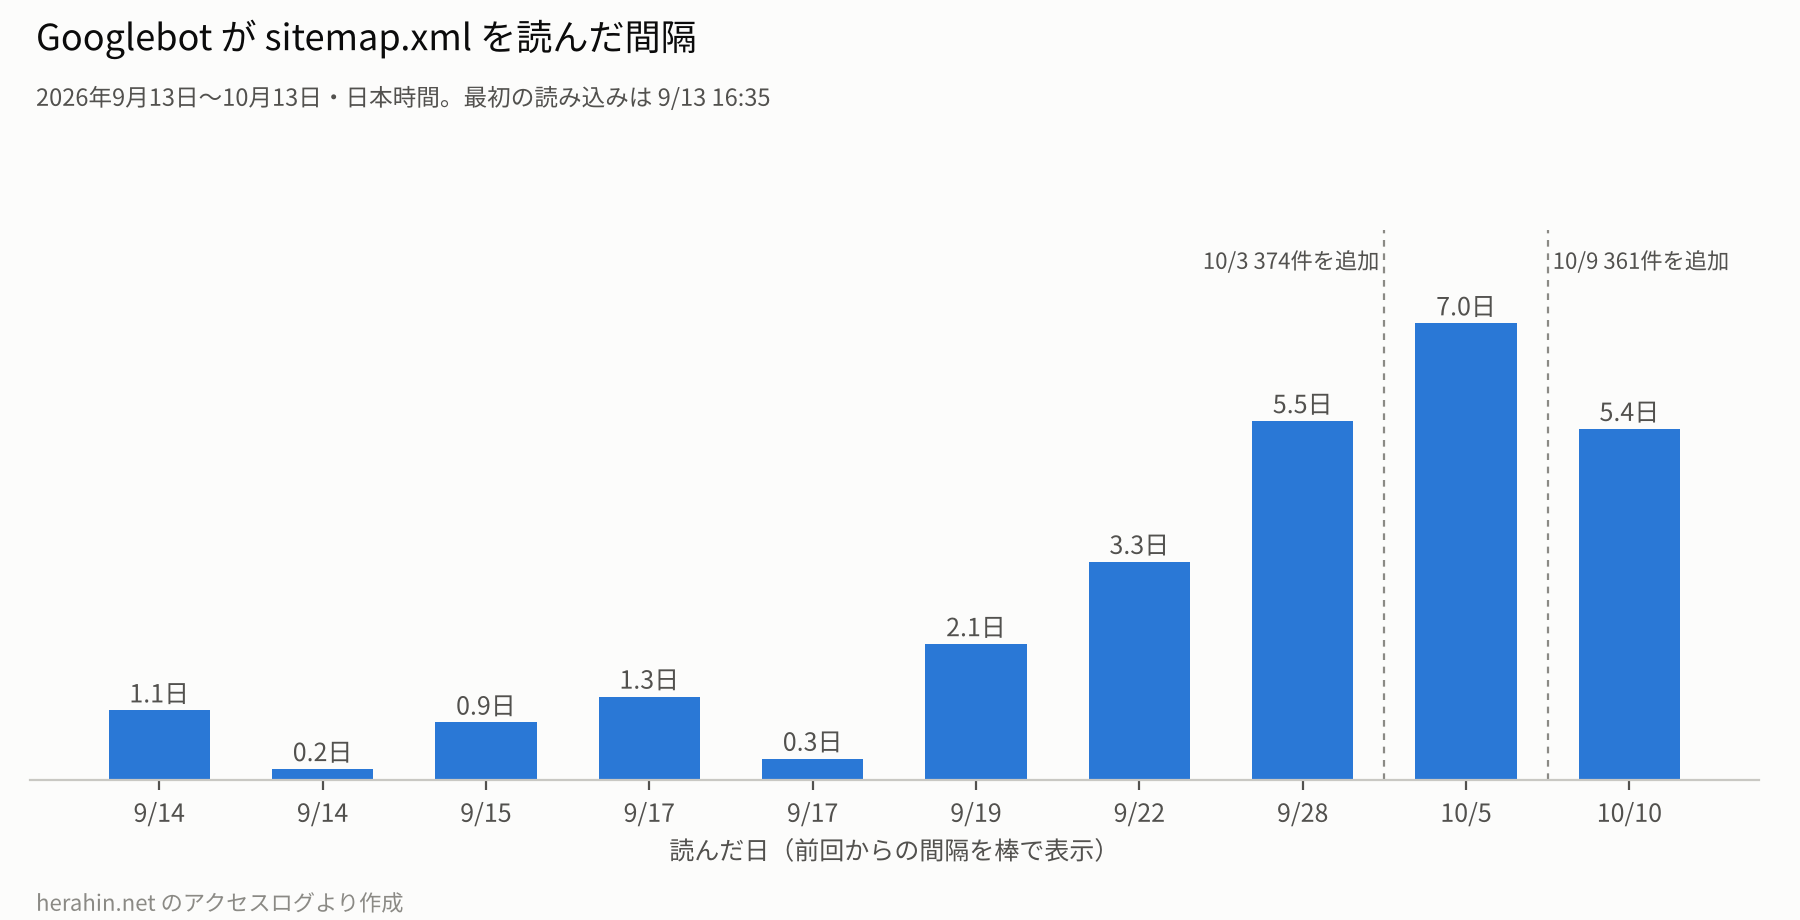 図3:Googlebot が sitemap.xml を読んだ間隔(9/13〜10/13)
最初の数日は1日に1回以上読んでいたのが、9月末には1週間に1回になっています。変化のないサイトだと判断されて、確認の頻度が下がったと考えられます。
10月:新しいページを出すと動く
10/3 に374件を追加公開すると、3日後の 10/6 に、初めて手動リクエストなしのインデックス登録がありました(練馬区氷川台三丁目)。次の日には、その隣接する7丁目がすべて取得されていました。登録されたページの隣接リンクをたどって、地図の上で広がっていったと考えられます(図4の練馬区東部)。
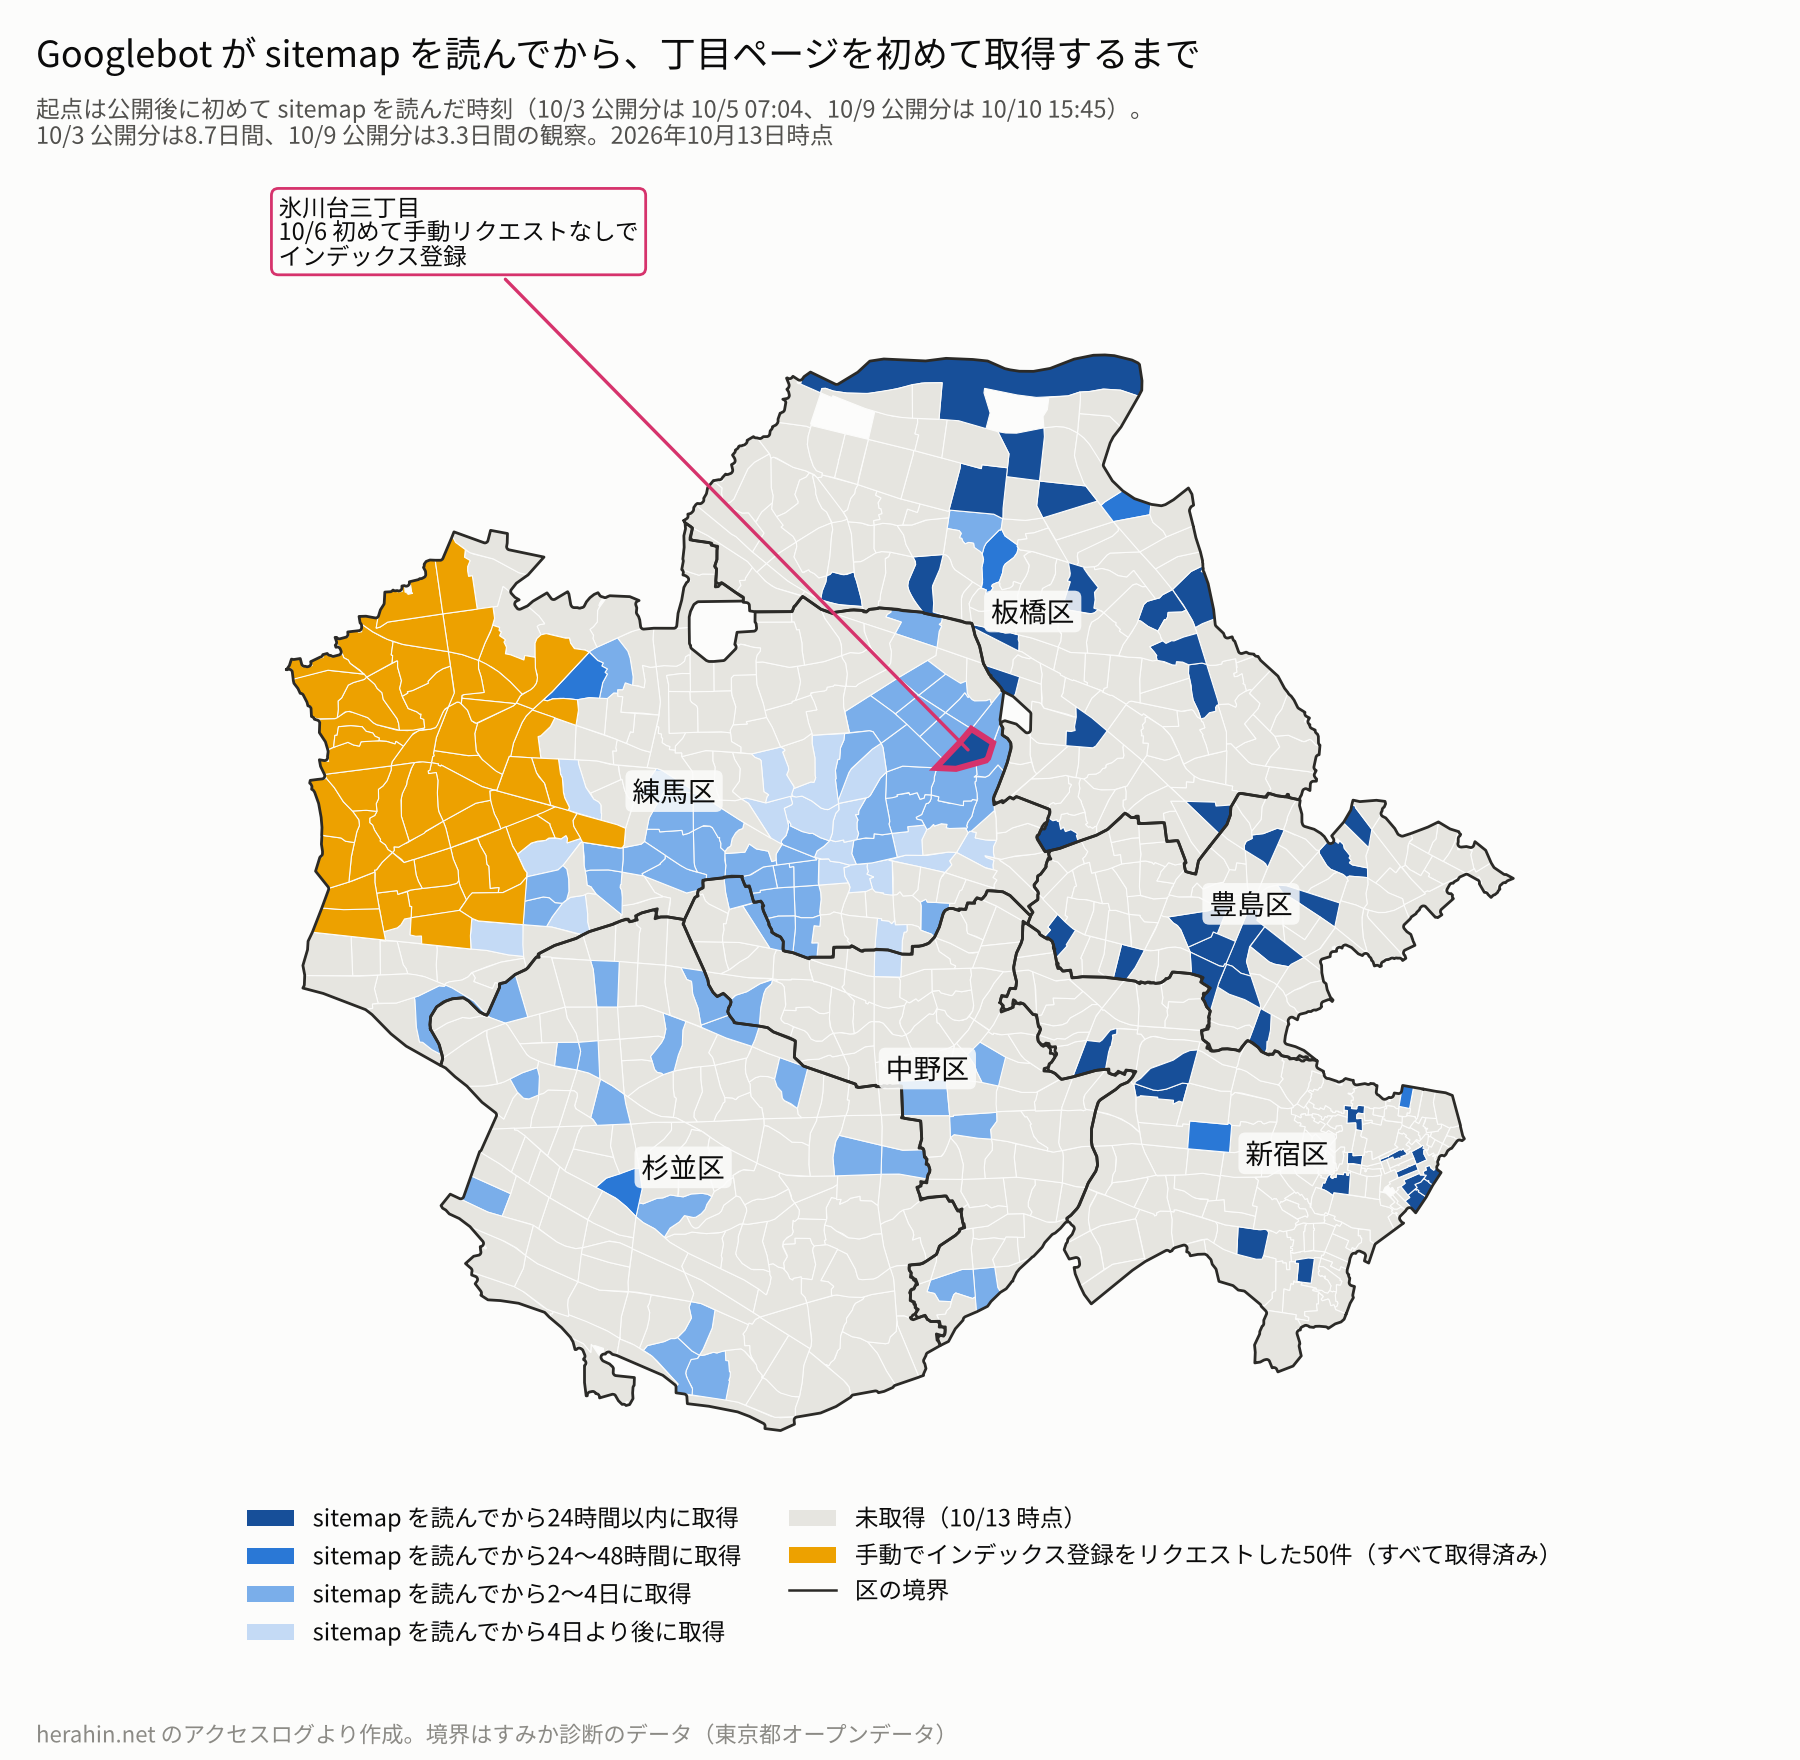 図4:Googlebot が sitemap を読んでから、丁目ページを初めて取得するまで(地図)(10/13 時点。10/3 公開分は8.7日間、10/9 公開分は3.3日間の観察。枠で囲んだのが、初めて手動リクエストなしで登録された氷川台三丁目)
公開した回どうしを比べるときは、公開した時刻ではなく、公開後にそのクローラが初めて sitemap を読んだ時刻を起点にしています。後に公開したページが後に取得されるのは当然なので、公開の時刻と巡回の周期の噛み合わせによる差を除いて、同じ基準で比べるためです。「公開 → sitemap を読む」と「sitemap を読む → 取得」の2段階に分けると、次のようになります。
| クローラ | 公開回 | 公開 → 次に sitemap を読むまで | sitemap を読む → 最初の取得 | sitemap を読む → 取得の中央値 | 取得数 | 取得割合 |
|---|---|---|---|---|---|---|
| Googlebot | 10/3 | 31.8時間 | 22.9時間 | 68.1時間 | 90/374 | 24% |
| Googlebot | 10/9 | 29.4時間 | 1.2時間 | 16.5時間 | 49/361 | 14% |
| Bingbot | 10/3 | 78.5時間 | 取得なし | — | 0/374 | 0% |
| Bingbot | 10/9 | 4.2時間 | 取得なし | — | 0/361 | 0% |
| ClaudeBot | 10/3 | 21.2時間 | 0.9時間 | 0.9時間 | 374/374 | 100% |
| ClaudeBot | 10/9 | 0.9時間 | 0.7時間 | 0.7時間 | 361/361 | 100% |
Googlebot が sitemap を読みに来るまでの時間は、どちらの回も約30時間でほぼ同じでした。違ったのは読んだ後で、10/3 公開分は最初の取得まで23時間かかったのに対し、10/9 公開分は1.2時間で取りに来ています(地図では、板橋区・豊島区・新宿区に濃い色が多い)。2回目の追加公開のときのほうが、新しい URL を優先して取りに来たことになります。
この基準は sitemap を読むクローラにしか使えません。GoogleOther、MJ12bot、10/3 以降の Meta は sitemap を読んでいないので、表に入れていません。Bing は sitemap を読んでも取りに来ないので、2段目が測れません。また、Googlebot の取得には、sitemap ではなく、登録されたページの隣接リンクをたどって広がった分も混ざっています。
10/9 に361件を追加したときも同じで、2日後に45件、その次の日に20件、さらに次の日は4件と、公開のたびに2〜4日の山ができて、その後は元に戻る形が2回ありました。
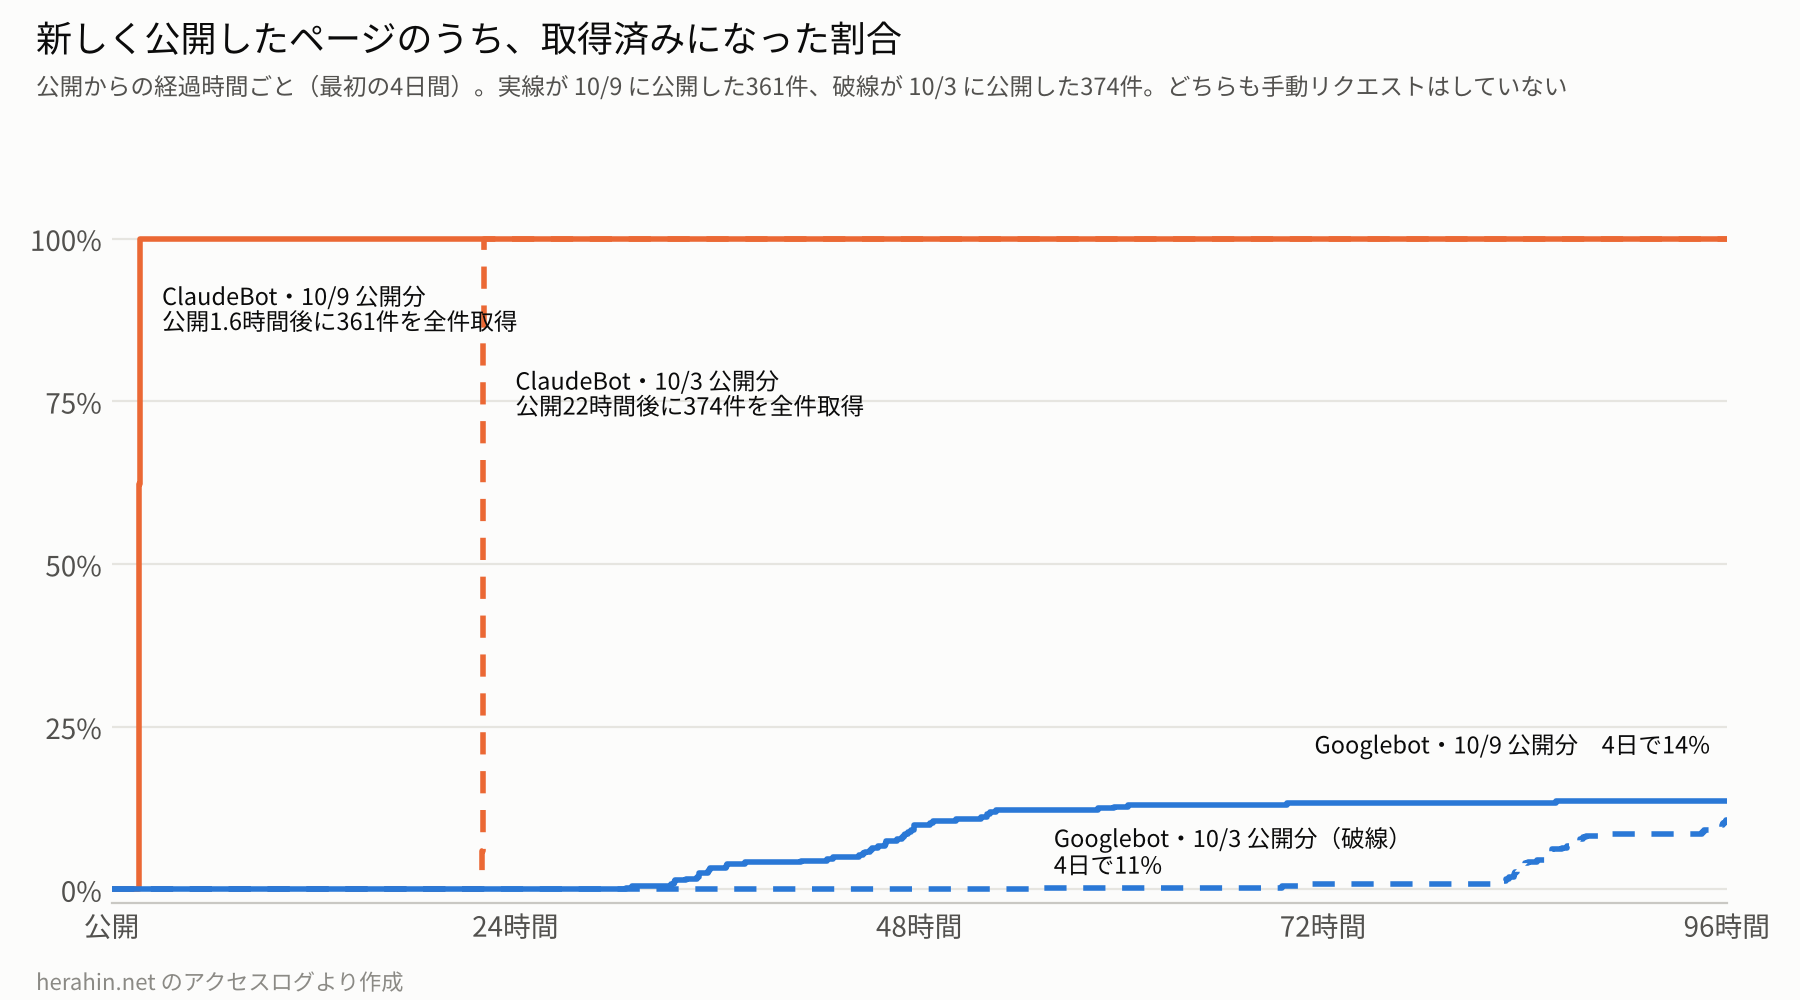 図5:公開からの経過時間と取得済みの割合(10/3 公開分と 10/9 公開分の、それぞれ公開から4日間)
手動でリクエストした50件と、それ以外
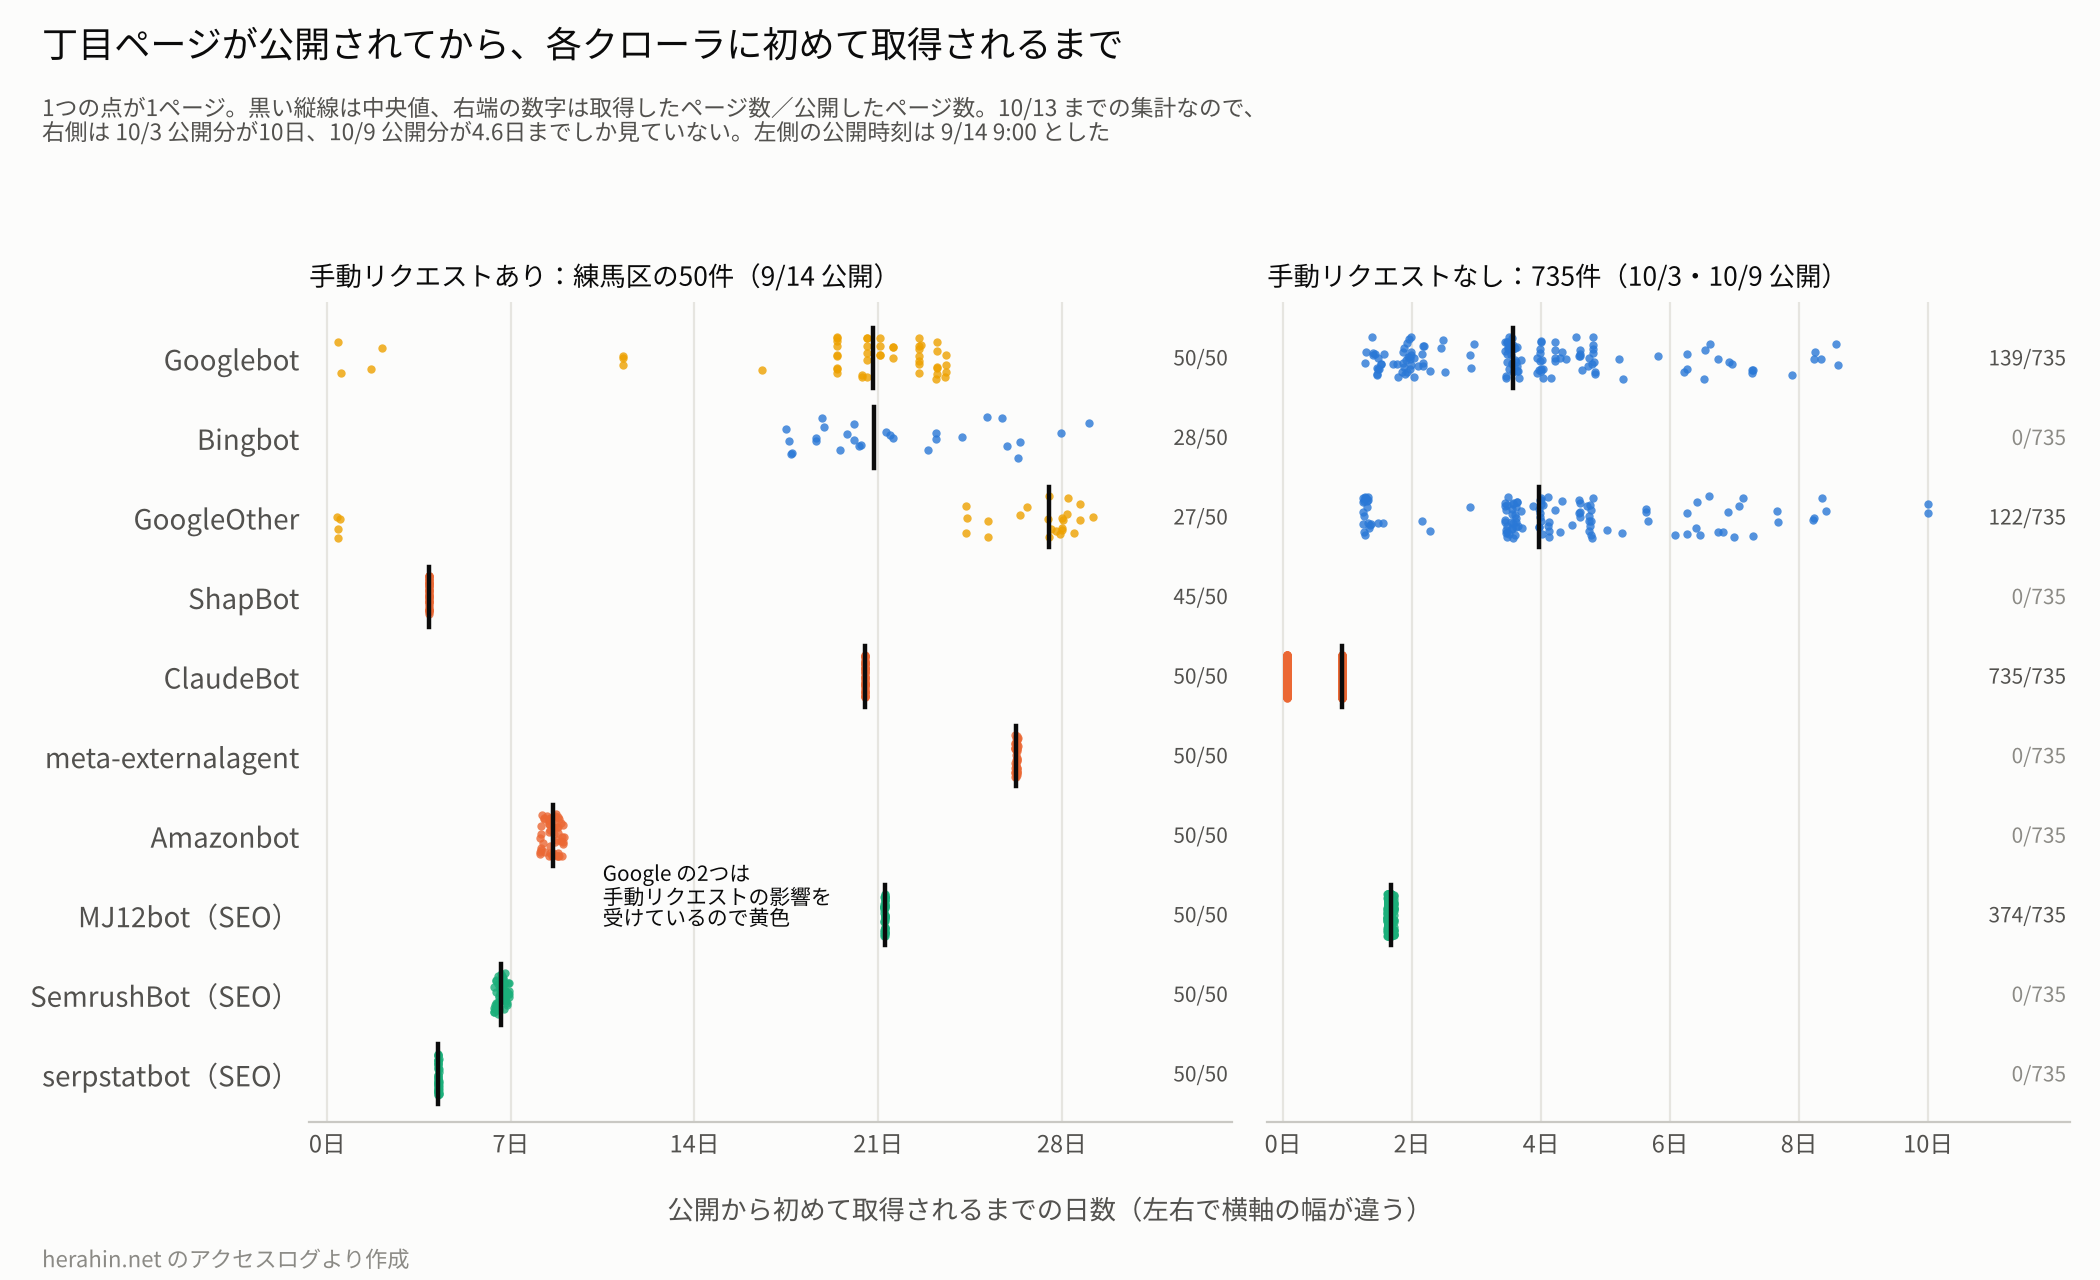 図6:公開から各クローラに初めて取得されるまで(手動リクエストした50件/それ以外の735件)(10/13 までの集計。10/3 公開分は10日、10/9 公開分は4.6日までしか見ていない)
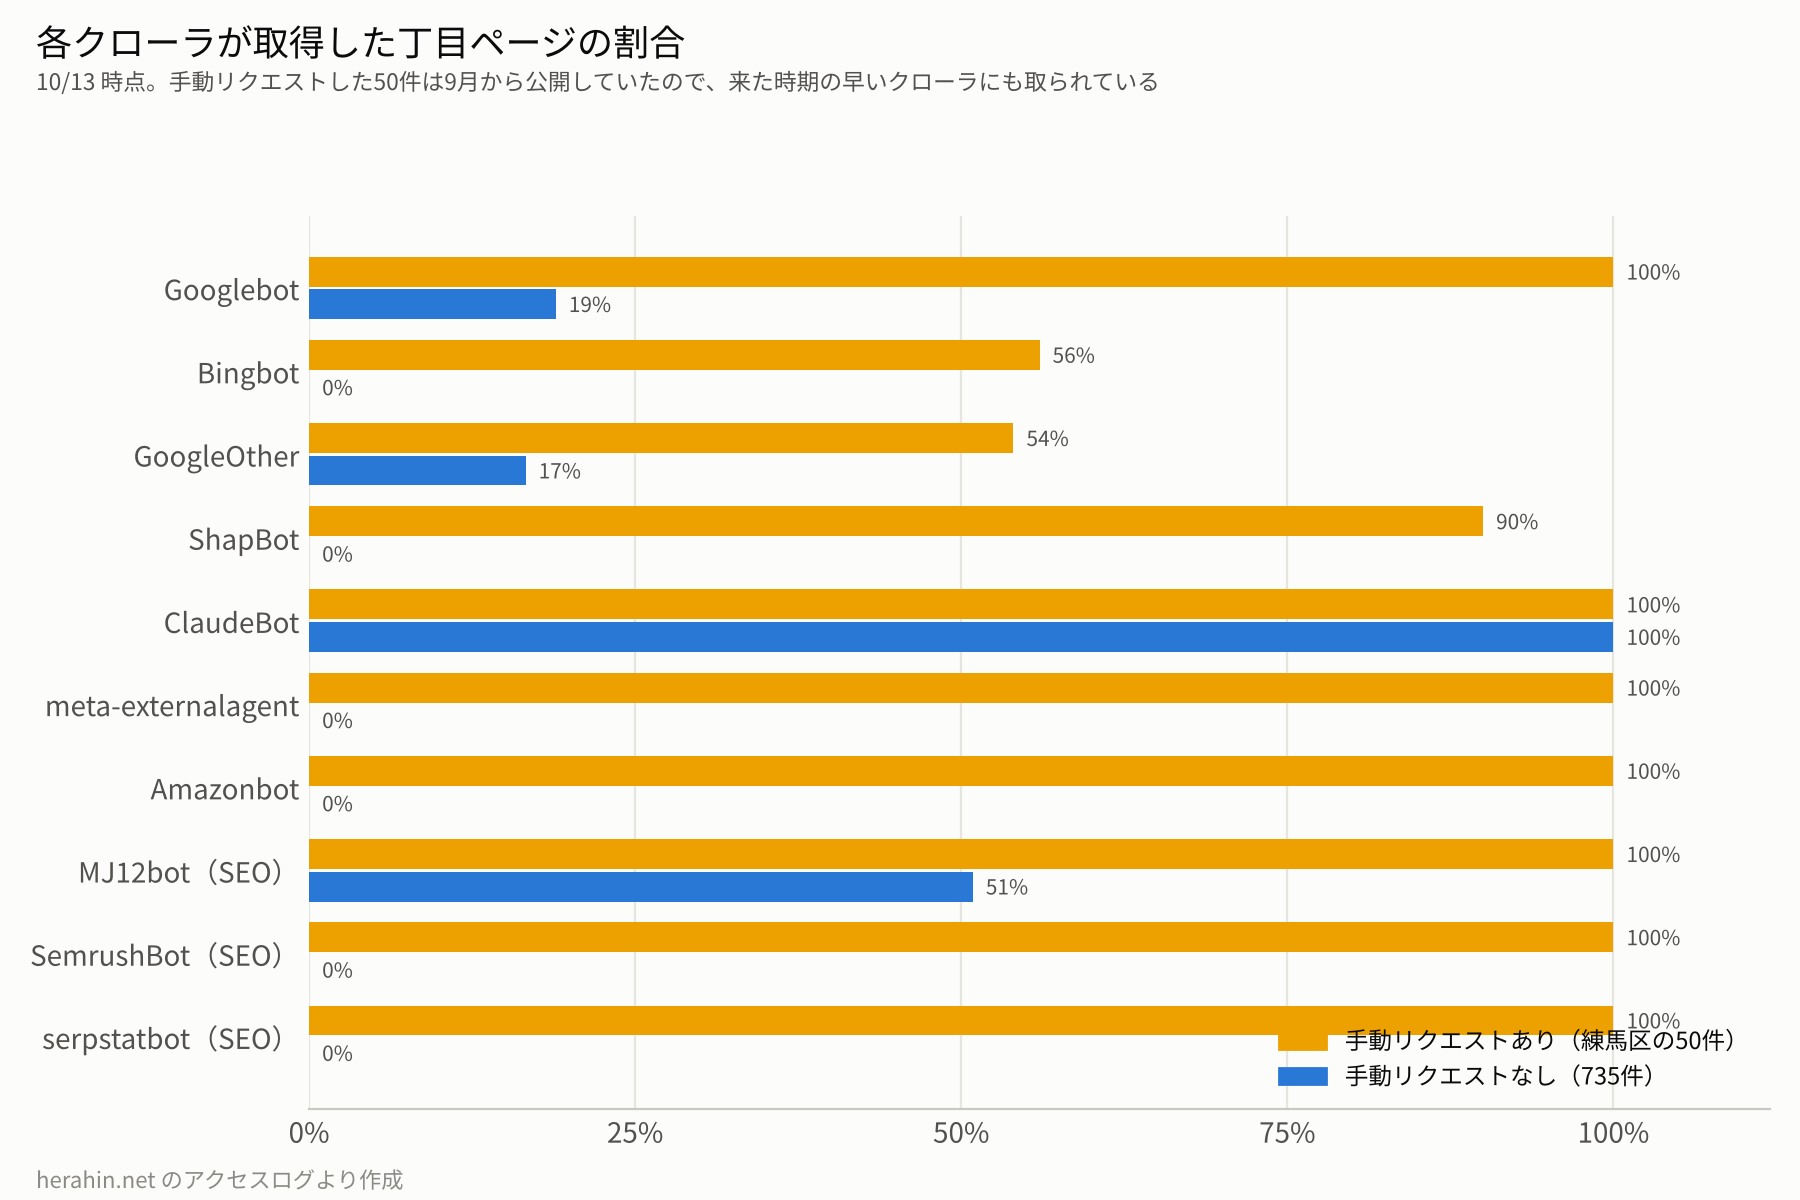 図7:各クローラが取得した丁目ページの割合(10/13 時点)
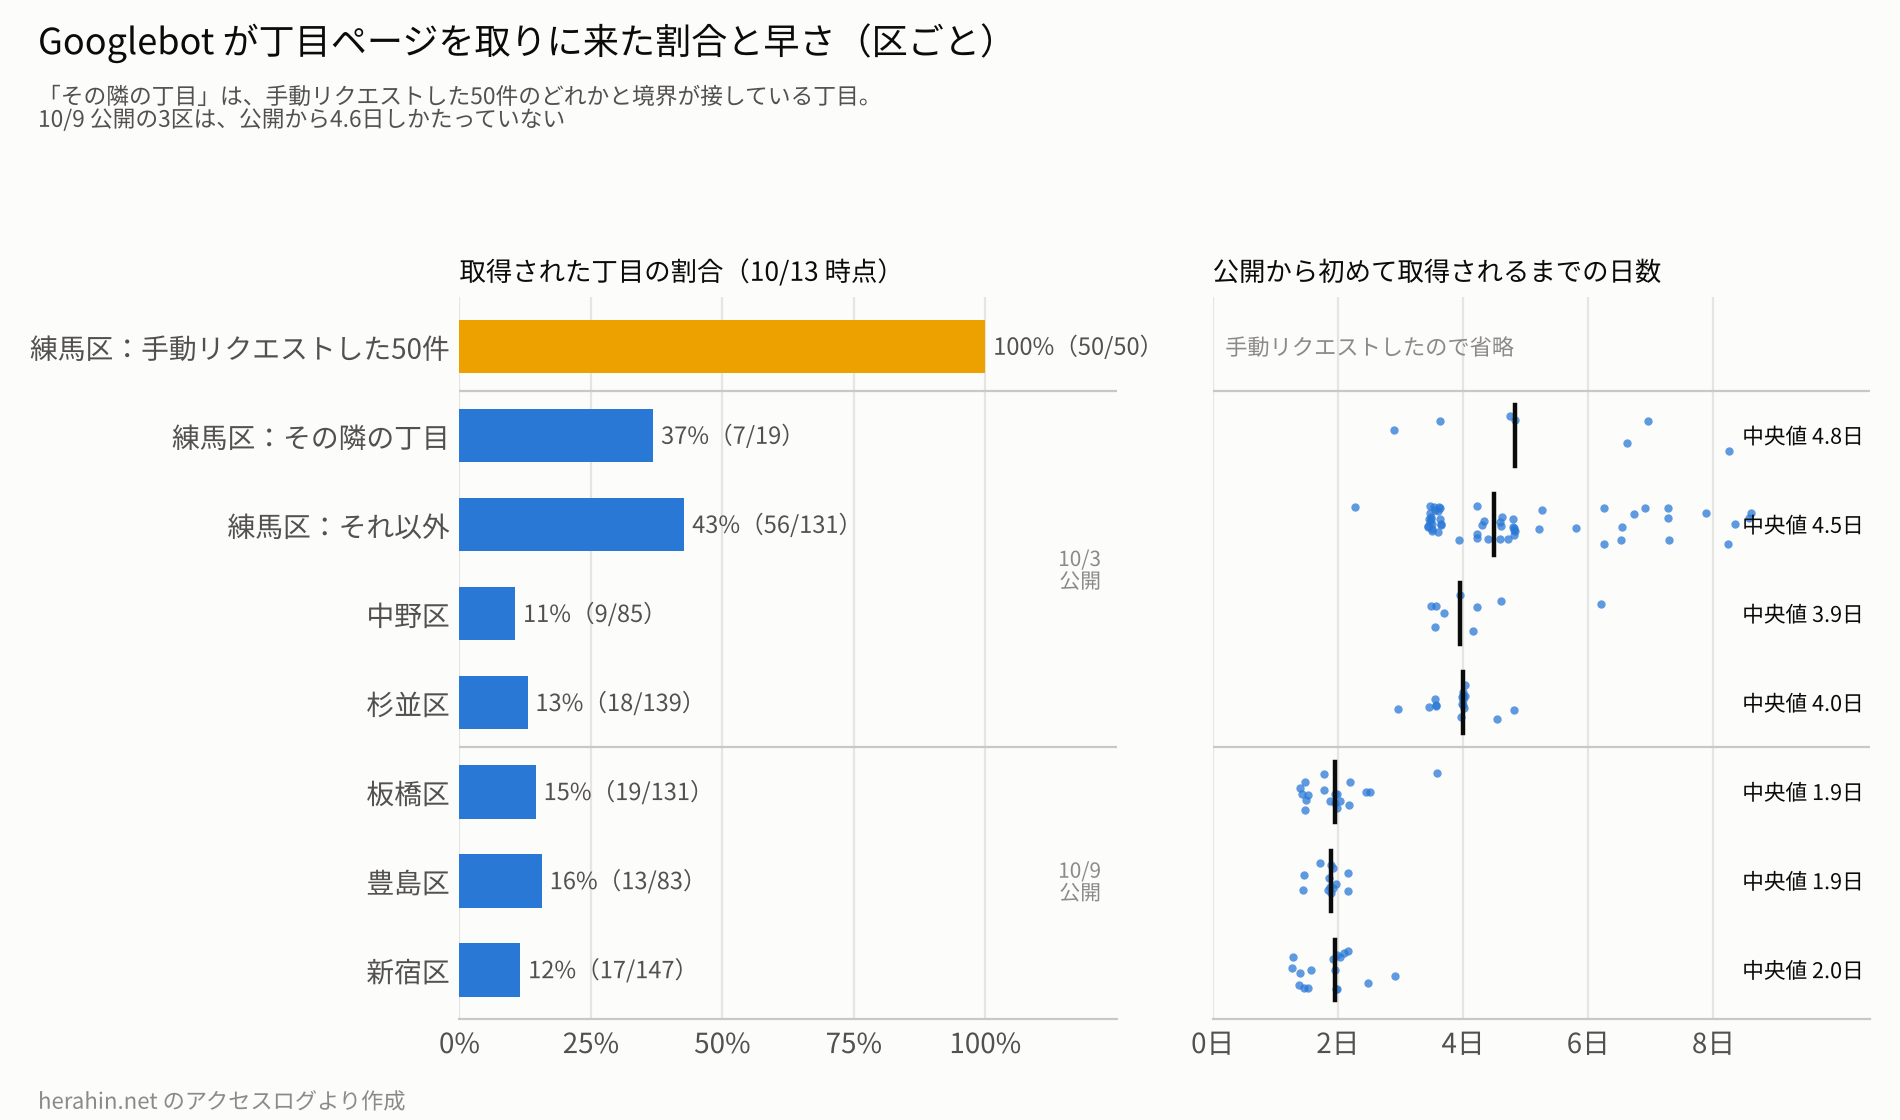 図8:区ごとの Googlebot の取得(10/13 時点。10/9 公開の3区は公開から4.6日)
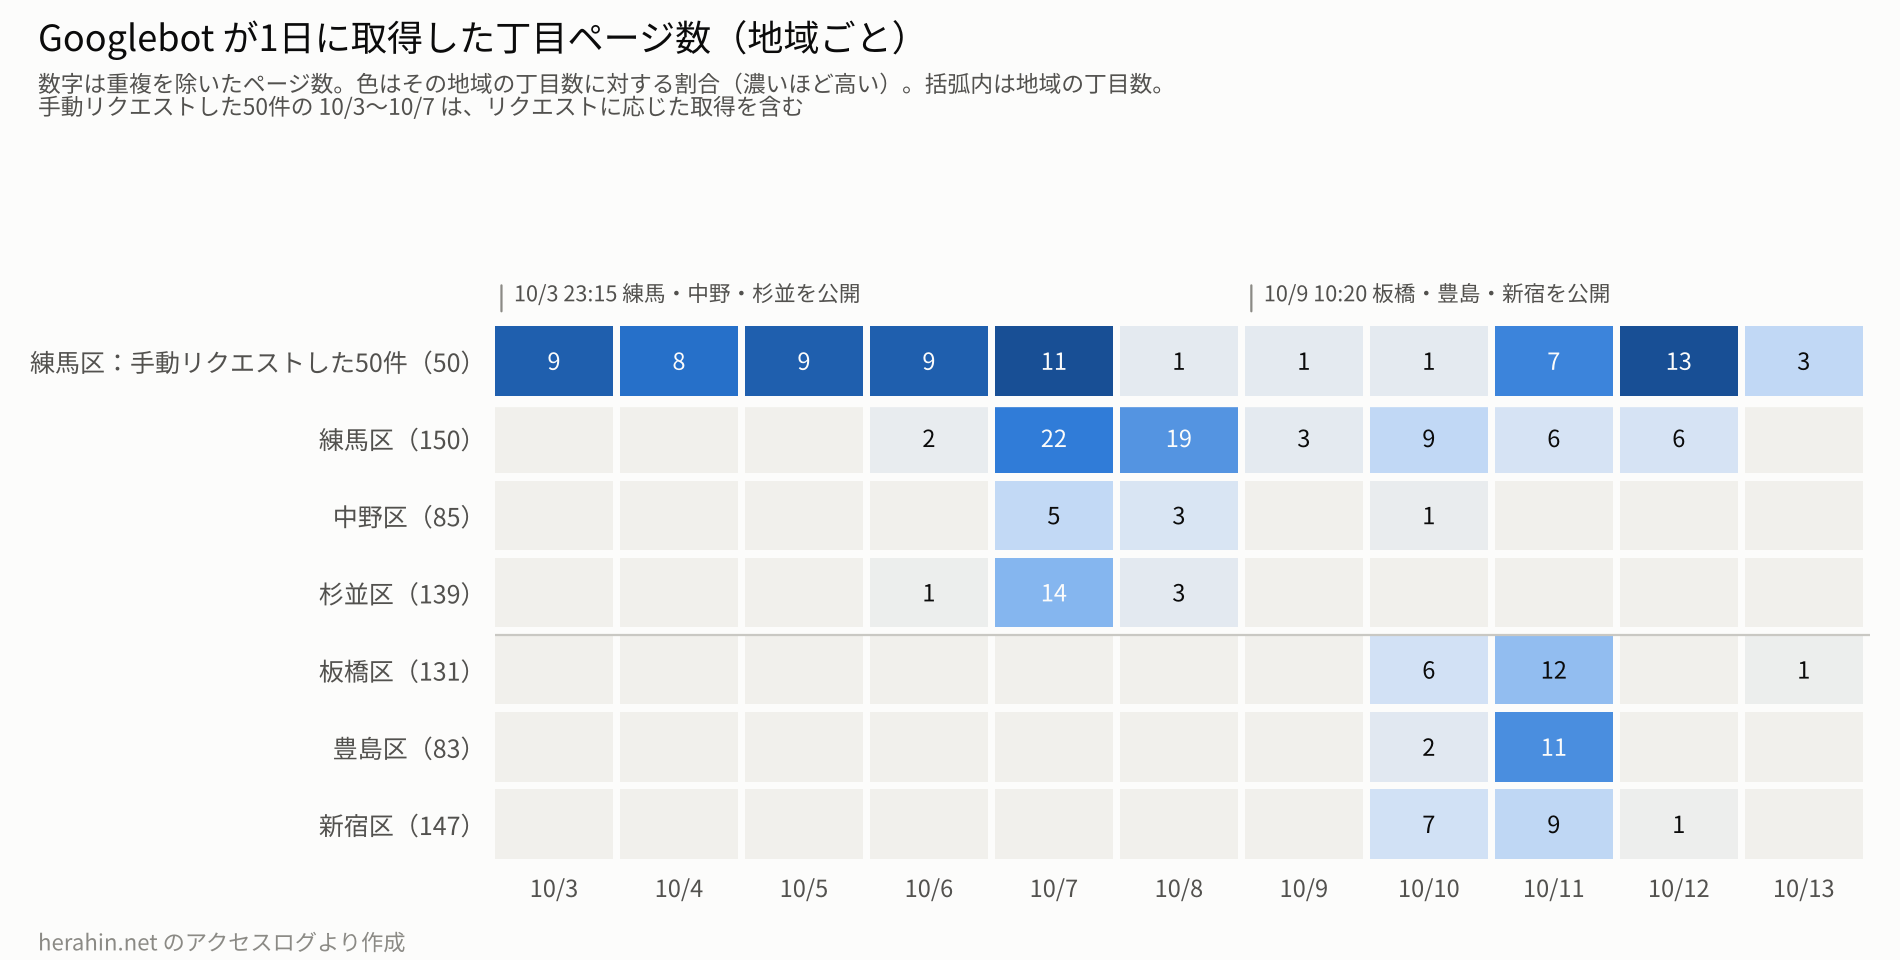 図9:Googlebot が1日に取得した丁目ページ数(地域ごと)(10/3〜10/13)
区ごとに比べると練馬区の取得が目立ちますが、練馬区の残り・中野区・杉並区は同じ 10/3 の公開です。差の多くは、手動でリクエストした50件と、それに隣接する19件から来ています(図8は練馬区をこの3つに分けて描いています)。
手動でリクエストした50件は練馬区の西側に固まっています。でも、自然なクロールが広がり始めたのは、自然に登録された東側からでした。手動で登録させたページが、周りへの入口になったわけではありません。
3.4 GoogleOther:Googlebot の少し前に来る
GoogleOther は、Google のさまざまなチームが社内の研究開発などで使う汎用のクローラで、robots.txt で止めても特定の製品には影響しないと説明されています(Google の一般的なクローラの一覧 )。
自然なクロールでは、GoogleOther が Googlebot より数十秒〜数十分前に同じページを取得していることが多くありました(10/3 公開分では34件中30件)。一方、手動でリクエストした44件では、GoogleOther が先に来たことは一度もありません。
なので、「GoogleOther が先に来ていれば自然なクロール」とは言えます。ただし、10/9 公開分では14件中2件だけで、時期によって割合は大きく変わりました。「来ていなければ手動」とも言えません。
3.5 Bing:IndexNow で通知した分しか取らない
Bingbot は、この1ヶ月で sitemap を22回読んでいます。それでも、取得した丁目ページは28件で(図7)、すべて 9/17 に IndexNow で通知した最初の50件の中のものでした。通知していない 10/3 以降の735件は、1件も取りに来ていません。
Bing は IndexNow を、サイトの変更を検索エンジンにすぐ知らせる仕組みとして案内しています。それでも、ここまではっきり分かれるとは思っていませんでした。少なくともこのサイトでは、sitemap を読むことと、そこに載った新しいページを取りに来ることは別でした。
ChatGPT の検索に Bing の結果が使われているなら、IndexNow を使わない新しいサイトは ChatGPT にも出にくいかもしれません。ただし、2026年の時点で ChatGPT の検索がどの程度 Bing に頼っているかは公表されていないので、ここは推測です。
3.6 AI 系のクローラ
ClaudeBot(Anthropic):sitemap の差分だけを取る
- 10/4 に初めて来て、その時点の424件を4分で全件取得しました。トップページは取得していません。
- その後は約2時間おき(中央値2.0時間、計111回)に robots.txt と sitemap だけを確認していました。
- 10/9 10:20 に361件を追加すると、11:15 の定期確認で見つけて、公開から1.6時間後に361件を4分で全件取得しました。
- すでに取得した424件は1件も取り直していません。区境でリンクが増えたページもありましたが、sitemap の更新日(lastmod)を変えていなかったので、変化を検知しなかったと考えられます。
| 公開から最初の取得まで | 4日以内に取得 | |
|---|---|---|
| ClaudeBot(10/3 公開分) | 22時間 | 374/374 |
| Googlebot(10/3 公開分) | 55時間 | 40/374 |
| ClaudeBot(10/9 公開分) | 1.6時間 | 361/361 |
| Googlebot(10/9 公開分) | 31時間 | 49/361 |
ClaudeBot は 10/4 が初訪問なので、10/3 公開分の「22時間」は初めて来るまでの時間です。
Meta:1回だけ読んだ sitemap を、1週間後に取りに来る
meta-externalagent が sitemap を読んだのは、この1ヶ月で 10/3 16:29 の1回だけです。その時点で sitemap に載っていた丁目は最初の50件だけでした(追加公開は同じ日の 23:15)。
そして1週間後の 10/10 に、その50件だけを約2分に1件のペースで取得しました。IP は40個以上に分散していました。10/3 以降に公開したページには1件も来ていません。「sitemap を読んだ時点の URL の一覧を、しばらくしてから取りに来る」と考えるのが、一番単純な説明です。
最初は「Google にインデックスされたページだけを選んでいる」と考えましたが、sitemap を読んだ時刻を確かめると違うと思われます。
OpenAI:来ているのに取らない
- OAI-SearchBot(ChatGPT の検索用)は31日間で53回来ましたが、53回とも robots.txt だけでした。丁目ページは0件です。
- GPTBot(学習用)は、9/25 から毎日 2:00 過ぎに sitemap を読んでいます(1日に数分ずつ遅れていく)。それでも、丁目ページを取ったのは 9/14 の1件だけでした。
- 10/12 に、自分で ChatGPT(検索あり)に試しに聞いてみました。サイト名だけで聞くと、OAI-SearchBot が robots.txt を見に来ただけで「特定できない」という回答でした。URL を含む文章を渡すと、ChatGPT-User が about、区のページ、丁目ページ9件を1分以内に取得し、回答の数字はすべて正確でした。
- OpenAI は、ChatGPT-User はユーザーの操作で動くので robots.txt のルールが適用されない場合があると説明しています(OpenAI のクローラの概要 )。実際、このときも robots.txt は読んでいませんでした。
- これは自分で誘導した質問なので、自然な利用の記録ではありません。OpenAI 側の検索インデックスには、まだ入っていないと考えています。
そのほか
- ShapBot(Parallel Web Systems)は 9/17 に45件を22分で取得しました。ShapBot は Parallel の検索インデックスを作るクローラで(Parallel のクローラの説明 )、その検索は2026年7月から Google の Gemini Enterprise Agent Platform で、回答の根拠(グラウンディング)に使える検索として組み込まれています(Google Developers Blog )。
- Amazonbot は 9/22 に50件を一度に取得しました。
3.7 参考:AI Overview がトップを引用
9/25 に「herahinスコア」で Google 検索すると、AI Overview が生成され、出典としてトップページが引用されていました。ただし、これはこのサイトで作った造語で検索した結果で、競合するページがありません。引用されやすさの証拠にはならないので、参考の記録にとどめます。
一方で、Gemini(アプリ)に聞いても herahin は出てこず、検索結果を根拠として使われていない状態でした。それでも AI Overview には出ていました。Google は、AI Overview に出るための条件を「インデックスに登録され、検索結果にスニペット付きで表示できること」としていて、特別な対策はいらないと説明しています(AI 機能とウェブサイト )。AI Overview は検索の仕組みの上で作られているので、検索にインデックスされていれば出る。Gemini アプリとは別経路になっていると思われます。
ここで引用されやすくするには、SEO と LLMO のどちらが有効なのかは、別途検証の余地があります。
4. 推測と異なった結果
仮説や推測と異なる結果になったことがありましたので、まとめておきます。
- Meta の選び方:「Google にインデックスされたページを選んでいる」と推測しましたが、sitemap を読んだ時刻から見ると、読んだ時点の一覧を後から取りに来たと考えるほうが自然でした(3.6)。
- スコアの高い順に登録される:9/25 の時点で、4件の登録状況からスコアとの関係を予測しましたが、手動リクエストした3件では、スコアの低いページも登録されました。n=4 で見えた相関は偶然だったと判断しています。
5. 限界
- 1つのサイトだけの記録です。ドメインの古さ、ジャンル、ページ数が違えば、結果は変わる可能性があります。
- 自分の閲覧が混ざっている可能性:2ヶ月目に入ってから、自分のブラウザでページを見ると、その後に Googlebot が来ることがあるとわかりました(詳しくは次の記事で書きます)。9/16 の分(3.3)のほかにも、1ヶ月目に自分で何度かページを確認しているので、Googlebot の取得の一部はそれがきっかけだった可能性があります。
- ログに残らないアクセス:DDoS 対策で拒否されたリクエストと、静的ファイルへのアクセス(9/18 以降)は記録していません。
- UA の偽装は区別できません。
- 手動リクエストや IndexNow は少数ながら行っているので、「完全に何もしていないサイト」の記録ではありません。
6. 次に見ること
2ヶ月目は、新しいページを1週間に1回まとめて出すのではなく、数日おきに少しずつ出す期間に入ります。Google の sitemap を読む間隔が、更新の頻度に合わせて縮むかを見ます。
付録
- 集計と作図のスクリプト:analyze.py 、figs.py 、figs2.py 、fig6.py 、fig9.py 、latency.py 。入力ファイルの形式は README.txt に書いています。
- 集計済みのデータ:日ごと・クローラごとの丁目ページ数(daily_chome_pages_by_bot.csv )。
- 生のログと丁目ごとのデータは公開していません。個別のページの URL や、検証の群の割り当てが推測できるためです。自分のサイトのログで追試する場合は、README の列の形式に合わせれば同じスクリプトで集計できます。